인터럽트 폴링 차이: 응답 시간과 CPU 사용률 및 선택 기준
임베디드 제어 시스템이나 고성능 실시간 운영체제(RTOS) 기반 아키텍처를 설계할 때, 외부 비동기 이벤트를 감지하고 처리하는 방식의 선택은 전체 시스템의 결정론적(Deterministic) 성능을 좌우하는 핵심 과제입니다. 특히 주기적인 레지스터 질의 방식과 하드웨어 트리거 통지 방식 사이에서 발생하는 인터럽트 폴링 차이를 명확히 이해하지 못하면, 불필요한 연산 주기 낭비로 전력 소모가 급증하거나 임계 시점의 이벤트를 놓치는 치명적인 레이턴시 병목 현상에 직면하게 됩니다.
단순 데이터 수집 루프에서는 순차적인 상태 조회가 구현 복잡도를 낮추는 직관적인 대안이 될 수 있지만, 센서 데이터의 버스트 유입이나 모터 드라이버의 과전류 보호 루틴과 같은 고속 응답 환경에서는 CPU 점유율이 100%에 도달하여 백그라운드 태스크 기아(Starvation)를 유발합니다. 따라서 시스템 설계자는 하드웨어 컨텍스트 스위칭 오버헤드와 소프트웨어 폴링 루프의 지연 시간을 엄밀히 계산하여 두 메커니즘 간의 실질적인 트레이드오프를 평가해야 합니다.
페이지내용
인터럽트 폴링 차이: 이벤트 처리 메커니즘과 CPU 점유율의 본질적 대조
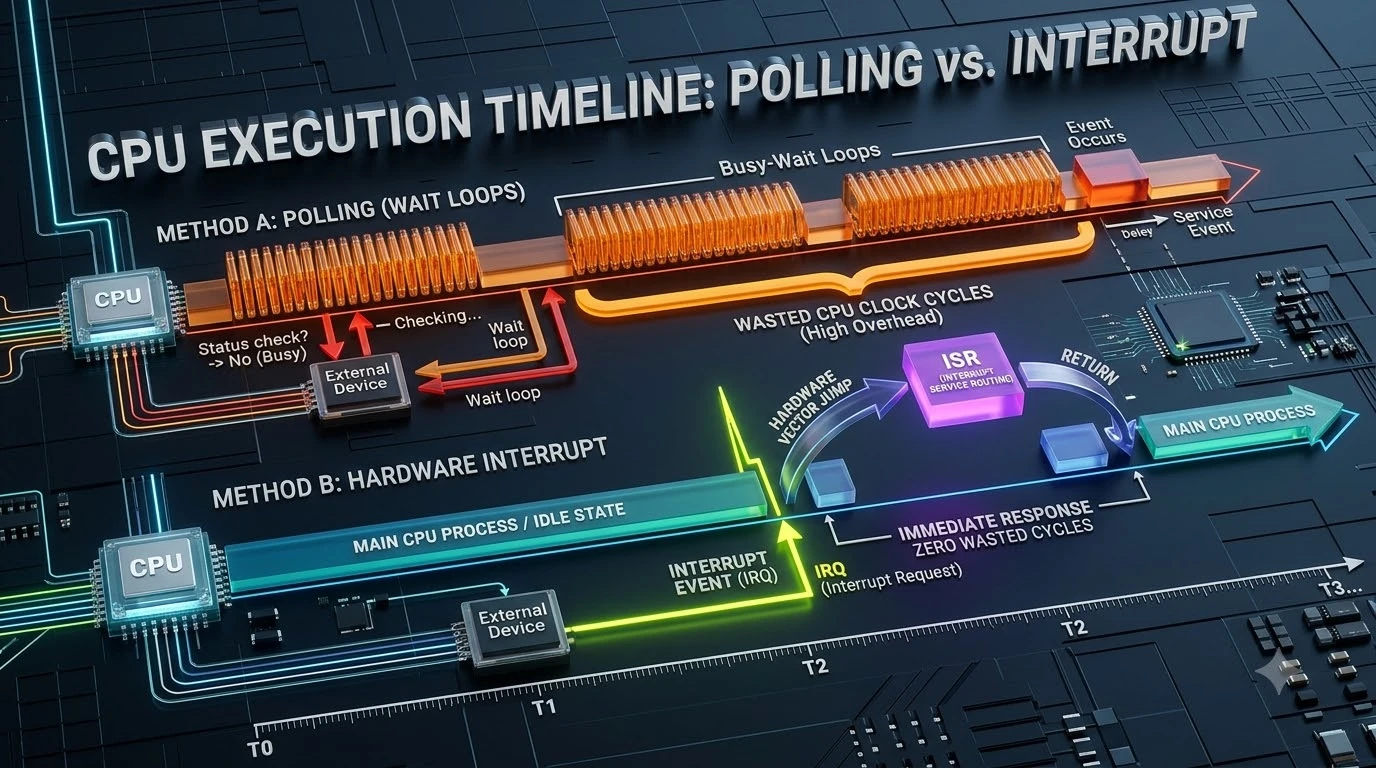
폴링(Polling)은 메인 프로그램 루프 내에서 특정 플래그 레지스터를 지속적으로 읽어 상태 변화를 능동적으로 확인하는 동기식 제어 방식입니다. 이벤트가 발생하지 않는 유휴 상태에서도 CPU는 분기문과 메모리 읽기 명령어를 계속 실행하므로 클록 사이클이 지속적으로 소모되며, 이벤트 발생 시점부터 실제 감지 시점까지 최대 폴링 주기만큼의 지연 시간(Latency)이 불가피하게 포함됩니다.
반면 인터럽트(Interrupt)는 주변장치나 외부 핀이 물리적 신호를 통해 중단 컨트롤러(NVIC, GIC 등)에 비동기적 알림을 전송하는 하드웨어 주도형 방식입니다. 평상시 CPU는 저전력 슬립(WFI/WFE) 모드로 대기하거나 다른 연산 태스크를 수행하다가, 신호가 트리거되는 즉시 현재 실행 컨텍스트를 스택에 보존하고 인터럽트 서비스 루틴(ISR)으로 점프하여 처리합니다.
“ARM Cortex-M4 프로세서의 중첩 벡터형 인터럽트 제어기(NVIC)는 고정 12사이클의 예외 진입 지연 시간(Exception Entry Latency)을 보장하며, 자동 하드웨어 스태킹(R0-R3, R12, LR, PC, xPSR)을 수행합니다. 꼬리 물기(Tail-chaining) 기술을 통해 연속된 인터럽트 간의 전환 오버헤드는 단 6사이클로 단축되어 실시간 응답 성능을 극대화합니다.”
— ARM Cortex-M4 Technical Reference Manual (Revision r0p1, Exception Handling)
위 공식 기술 규격에서 명시하듯, 인터럽트 방식은 하드웨어 단에서 자동 컨텍스트 저장을 지원하여 극히 짧은 결정론적 진입 시간을 보장합니다. 그러나 이벤트 빈도가 수십 kHz 이상으로 급증할 경우 빈번한 레지스터 푸시/팝 오버헤드로 인해 발생하는 인터럽트 폭풍(Interrupt Storm)이 오히려 폴링보다 더 심각한 스루풋 저하를 초래할 수 있습니다.
응답 시간·자원 소모·처리량 지표 비교
하드웨어 자원 최적화 관점에서 폴링과 인터럽트는 전력 소모, 시스템 지연, 코드 복잡도 측면에서 명확한 설계 분기점을 제공합니다. 두 기법의 핵심 엔지니어링 파라미터를 정밀 대조한 결과는 다음과 같습니다.
| 비교 파라미터 | 폴링 방식 (Polling) | 인터럽트 방식 (Interrupt) |
|---|---|---|
| 이벤트 응답 시간 (Latency) | 가변적 (0 ~ 최대 폴링 루프 실행 주기) | 결정론적 (NVIC 하드웨어 진입 사이클 고정) |
| 유휴 상태 CPU 점유율 | 100% (바쁜 대기 루프 지속 실행) | 0% (슬립 모드 또는 일반 태스크 수행) |
| 컨텍스트 스위칭 오버헤드 | 없음 (단순 함수 호출 및 분기 처리) | 발생 (레지스터 푸시/팝, 파이프라인 플러시) |
| 초고속 버스트 수신 효율 | 우수함 (전용 루프에서 파이프라인 손실 없음) | 저하 위험 (빈번한 ISR로 CPU 포화) |
| 동시성 제어 및 디버깅 | 단순함 (선형 흐름, 경쟁 상태 부재) | 복잡함 (임계 영역, volatile, 데드락 위험) |
위 데이터에서 확인되듯, 이벤트의 발생 간격이 불규칙하거나 발생 빈도가 낮은 시스템에서는 인터럽트가 전력 효율과 메인 프로세서 활용도 면에서 압도적인 우위를 점합니다. 반면 기가비트 이더넷 패킷 수신이나 초고속 ADC 연속 샘플링과 같이 이벤트가 쉴 새 없이 밀려드는 워크로드에서는 오히려 폴링이나 DMA 기반 링 버퍼 결합 구조가 스위칭 오버헤드를 배제하는 해법이 됩니다.
실전 펌웨어 구현: STM32 레지스터 기반 폴링 vs 비동기 인터럽트
아키텍처의 동작 원리를 검증하기 위해 STM32F4 마이크로컨트롤러 환경에서 USART 주변장치 수신단을 각각 블로킹 폴링 방식과 하드웨어 인터럽트 방식으로 제어하는 C 언어 드라이버 소스 코드입니다.
#include <stdint.h>
#include <stdbool.h>
#include "stm32f4xx.h"

// 1. 블로킹 폴링 수신: 데이터가 인입될 때까지 CPU가 루프에 묶임 (100% 점유)
uint8_t UART_Receive_Polling_Blocking(void) {
    // RXNE(Receive Data Register Not Empty) 플래그가 세트될 때까지 바쁜 대기
    while (!(USART1->SR & USART_SR_RXNE)) {
        // 이 구간 동안 CPU는 다른 태스크를 일절 수행하지 못함
    }
    return (uint8_t)(USART1->DR & 0xFF);
}

// 2. 비동기 인터럽트 기반 수신 초기화 및 ISR 처리 루틴
#define RX_BUFFER_SIZE 128
volatile uint8_t g_rx_buffer[RX_BUFFER_SIZE];
volatile uint16_t g_rx_head = 0;
volatile uint16_t g_rx_tail = 0;

void UART_Interrupt_Mode_Init(void) {
    // USART1 RXNE 인터럽트 인에이블 비트 설정
    USART1->CR1 |= USART_CR1_RXNEIE;

    // NVIC 인터럽트 채널 활성화 및 우선순위 지정 (Priority: 2)
    NVIC_SetPriority(USART1_IRQn, 2);
    NVIC_EnableIRQ(USART1_IRQn);
}

// 하드웨어 벡터 점프를 통해 즉시 실행되는 서비스 루틴 (Cortex-M 자동 스태킹)
void USART1_IRQHandler(void) {
    uint32_t status = USART1->SR;

    if (status & USART_SR_RXNE) {
        uint8_t data = (uint8_t)(USART1->DR & 0xFF);
        uint16_t next_head = (g_rx_head + 1) % RX_BUFFER_SIZE;

        // 링 버퍼 오버플로 방지 검증 후 저장
        if (next_head != g_rx_tail) {
            g_rx_buffer[g_rx_head] = data;
            g_rx_head = next_head;
        }
        // DR 읽기 완료 시 하드웨어에 의해 RXNE 플래그 자동 클리어
    }
}
위 코드에서 볼 수 있듯이 폴링 방식은 `USART_SR_RXNE` 비트가 1이 될 때까지 CPU가 명령어 파이프라인을 회전시키며 대기합니다. 반면 인터럽트 방식은 하드웨어가 NVIC을 통해 즉각 함수 실행을 전환하므로, 메인 스레드는 백그라운드에서 신호 처리 알고리즘을 중단 없이 수행할 수 있습니다.
실무 시스템 설계를 위한 선택 기준 체크리스트
- 이벤트 발생 빈도: 초당 이벤트 수가 1,000회 미만인 비주기적 입력(버튼, 센서 임계 알림)은 무조건 인터럽트를 적용한다.
- 실시간 제약(Hard Real-time): 비상 정지 스위치, 과전류 트립 등 10µs 이내의 확정적 응답이 요구되면 전용 외부 인터럽트(EXTI)를 할당한다.
- 초고속 데이터 스트림: 초당 수십만 번 이상 발생하는 고속 직렬 데이터 수신은 인터럽트 대신 DMA(Direct Memory Access) 컨트롤러로 분로한다.
- 배터리 기반 초저전력: 폴링 대기를 전면 배제하고, WFI(Wait For Interrupt) 지침을 통해 이벤트 발생 전까지 코어 클록을 게이팅한다.
실무 엔지니어링 FAQ
Q1. 인터럽트 서비스 루틴(ISR) 내부에서 딜레이(Delay) 함수나 무거운 연산을 넣으면 왜 안 됩니까?
ISR은 프로세서의 정상적인 태스크 스케줄링을 중단시키고 높은 하드웨어 우선순위로 실행됩니다. ISR 내부에서 수 밀리초 이상의 지연이 발생하면 동일하거나 더 낮은 우선순위의 다른 모든 인터럽트 처리가 블로킹되어 시스템 전반의 실시간성이 파괴됩니다. ISR에서는 데이터 버퍼링과 플래그 세트만 신속히 처리하고 복잡한 연산은 메인 태스크나 RTOS 워커 스레드로 넘겨야 합니다.
Q2. 폴링과 인터럽트를 혼합하여 설계하는 하이브리드(NAPI) 방식은 어떤 경우에 씁니까?
리눅스 네트워크 스택의 NAPI(New API) 구조처럼 트래픽 변동 폭이 극심한 시스템에서 사용됩니다. 패킷이 처음 도착할 때는 인터럽트로 감지하여 즉시 반응한 뒤, 대량의 데이터가 연속 인입되는 동안에는 인터럽트를 일시 차단(Disable)하고 폴링 모드로 대량 패킷을 일괄 수거하여 컨텍스트 스위칭 오버헤드를 억제합니다.
Q3. 인터럽트 기반 전역 변수를 선언할 때 반드시 volatile 키워드를 붙여야 하는 이유는 무엇입니까?
컴파일러 최적화 옵션(예: -O2, -O3)이 활성화되면 메인 루프에서 값이 변경되지 않는 변수를 레지스터에 캐싱하여 재사용합니다. `volatile`을 선언하지 않으면 비동기적으로 ISR이 메모리 변수 값을 갱신하더라도 메인 루프는 캐시된 구형 레지스터 값만 읽어 상태 변화를 영구히 감지하지 못하는 치명적인 버그가 발생합니다.
공식 기술 문서 및 가이드라인
이 글은 정보 제공을 목적으로 작성되었으며, 실제 기기·환경·정책에 따라 결과가 다를 수 있습니다. 보다 정확하고 최신인 정보는 아래 공신력 있는 기관의 자료를 함께 참고하시기 바랍니다.